تاریخ:



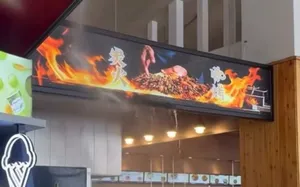
 فعال شدن سیستم اطفای حریق در چین با دیدن تصویر شعلههای آتش روی تابلو
 درس صد و نوزده
پیشی گرفتن ChatGPT در تشخیص بیماری تنفسی کودکان از پزشکان کارآموز

چتبات ChatGPT در یک پژوهش جدید، برای ارزیابی مشکلات پیچیده تنفسی در بیماریهایی مانند فیبروز سیستیک، آسم و عفونت قفسه سینه، بهتر از پزشکان کارآموز عمل کرد.
بررسی جدید پژوهشگران بریتانیایی نشان میدهد که ChatGPT در بررسی بیماریهای تنفسی کودکان میتواند بهتر از پزشکان کارآموز عمل کند.
به گزارش خبرگزاری ایسنا، چتبات ChatGPT در یک پژوهش جدید، برای ارزیابی مشکلات پیچیده تنفسی در بیماریهایی مانند فیبروز سیستیک، آسم و عفونت قفسه سینه، بهتر از پزشکان کارآموز عمل کرد.
به نقل از مدیکال اکسپرس، این بررسی نشان داد که چتبات «بارد»(Bard) شرکت «گوگل» در برخی جنبهها بهتر از کارآموزان عمل کرده و عملکرد چتبات «بینگ»(Bing) شرکت «مایکروسافت» نیز به خوبی کارآموزان بوده است.
نتایج بهدستآمده نشان میدهند که این مدلهای زبانی بزرگ را میتوان برای حمایت از پزشکان کارآموز، پرستاران و پزشکان عمومی به منظور تریاژ سریعتر بیماران و کاهش فشار بر خدمات بهداشتی مورد استفاده قرار داد.
این پژوهش توسط دکتر «منجیث نارایانان»(Manjith Narayanan) مشاور ریه اطفال در «بیمارستان سلطنتی کودکان و جوانان» و مدرس ارشد بالینی در «دانشگاه ادینبرو»(University of Edinburgh) انجام شد.
نارایانان گفت: مدلهای زبانی بزرگ مانند ChatGPT در یک سال و نیم گذشته به خاطر توانایی خود در درک زبان طبیعی و ارائه پاسخهایی برای شبیهسازی گفتوگوهای مشابه گفتوگوهای انسان مطرح شدهاند. این مدلها کاربردهای بالقوه متعددی را در پزشکی دارند. انگیزه من برای انجام دادن این پژوهش، ارزیابی این موضوع بود که مدلهای زبانی بزرگ تا چه اندازه میتوانند به پزشکان در زندگی واقعی کمک کنند.
برای بررسی این موضوع، نارایانان از سناریوهای بالینی استفاده کرد که اغلب در طب تنفسی کودکان اتفاق رخ میدهند. این سناریوها توسط شش متخصص دیگر حوزه طب تنفسی کودکان ارائه شد و بیماریهایی را مانند فیبروز سیستیک، آسم، اختلال تنفس در خواب، تنگی نفس و عفونت قفسه سینه پوشش داد. همه این بیماریها سناریوهایی بودند که در آنها هیچ تشخیص واضحی وجود ندارد و شواهد منتشر شده، تشخیص یا طرح خاصی را نشان نمیدهند.
راهحلهای ارائهشده توسط ChatGPT به طور میانگین امتیاز هفت را از ۹ امتیاز به دست آوردند و اعتقاد بر این بود که بیشتر از پاسخهای سایر چتباتها شبیه به پاسخ انسان هستند. بارد به طور میانگین امتیاز شش را کسب کرد و عنوان «پاسخ منسجمتر» را از سوی پزشکان گرفت اما از جنبههای دیگر بهتر یا بدتر از پزشکان کارآموز نبود. بینگ به طور میانگین امتیاز چهار را به دست آورد که به اندازه امتیاز کلی پزشکان کارآموز بود. کارشناسان به طور قابل اطمینان، پاسخهای بینگ و بارد را غیر انسانی تشخیص دادند.
نارایانان گفت: تا جایی که میدانم، پژوهش ما اولین پژوهشی است که مدلهای زبانی بزرگ را در برابر پزشکان کارآموز در شرایط منعکسکننده عملکرد بالینی واقعی آزمایش میکند. ما مستقیما آزمایش نکردهایم که چگونه مدلهای زبانی بزرگ در رویارویی با بیمار کار میکنند. با وجود این، پرستاران، پزشکان کارآموز و پزشکان مراقبتهای اولیه که اغلب اولین افراد بررسیکننده شرایط بیمار هستند، میتوانند از آن استفاده کنند.
 افزودن عصرایران به منابع ترجیحی گوگل


لینک کوتاه: کپی لینک
حسن شریعتمداری: می توانیم «ستون فقرات اینترنت جهانی» در اعماق خلیج فارس را هدف قرار دهیم بانک دی بر توسعه بازار و جذب شرکای کلیدی در نمایشگاه نظام مالی کامیون کشنده با رانندگی دختر ۱۲ ساله توقیف شد آیدا پناهنده خطاب به برخی مدیران صداوسیما: مردم دنبال هوای تازهاند، نه قصههای تکراری! وزیر اقتصاد: تورم تا ۹ ماه آینده به کانال ۴۰ درصد بازمیگردد ترامپ: احتمال دستیابی به توافق صلح در اوکراین زیاد است سفیر ایران در آلمان: کودکان میناب قربانی دو بمب کثیف شدند یحیی سریع: رژیم سعودی طی 24 ساعت 78 بار به یمن حمله کرد دانمارک وابسته نظامی روسیه را اخراج کرد وزارت دفاع روسیه از حمله به نیروگاه حرارتی اوکراین خبر داد ژئوسل چیست و چه کاربردی دارد؟ فناوری جالب لانه زنبوری برای تثبیت خاک و ساخت جاده را ببینید ترامپ: ایران توافق میخواهد، اما شرایط ما را نمیپذیرد/ جنگ علیه ایران یک اقدام نظامی کوچک است! دولت های مختلف جهان از چه هواپیماهایی استفاده می کنند؟ (تصویری) ماجرای اتاق شکنجه نزدیک کی یف چه بود؟ پشت پرده ویدئوی جنجالی اوکراین سخنگوی صنعت برق: پیامک ارسالی به مشترکان برق، برای تعمیرات شبکه است/ خاموشی ها اطلاع رسانی می شود