تاریخ:



 ۳۰ هواپیمای مسافربری در جنگ از بین رفت
 درس صد و شش
شخصیت چتباتها با تغییر زبان آنها عوض میشود!
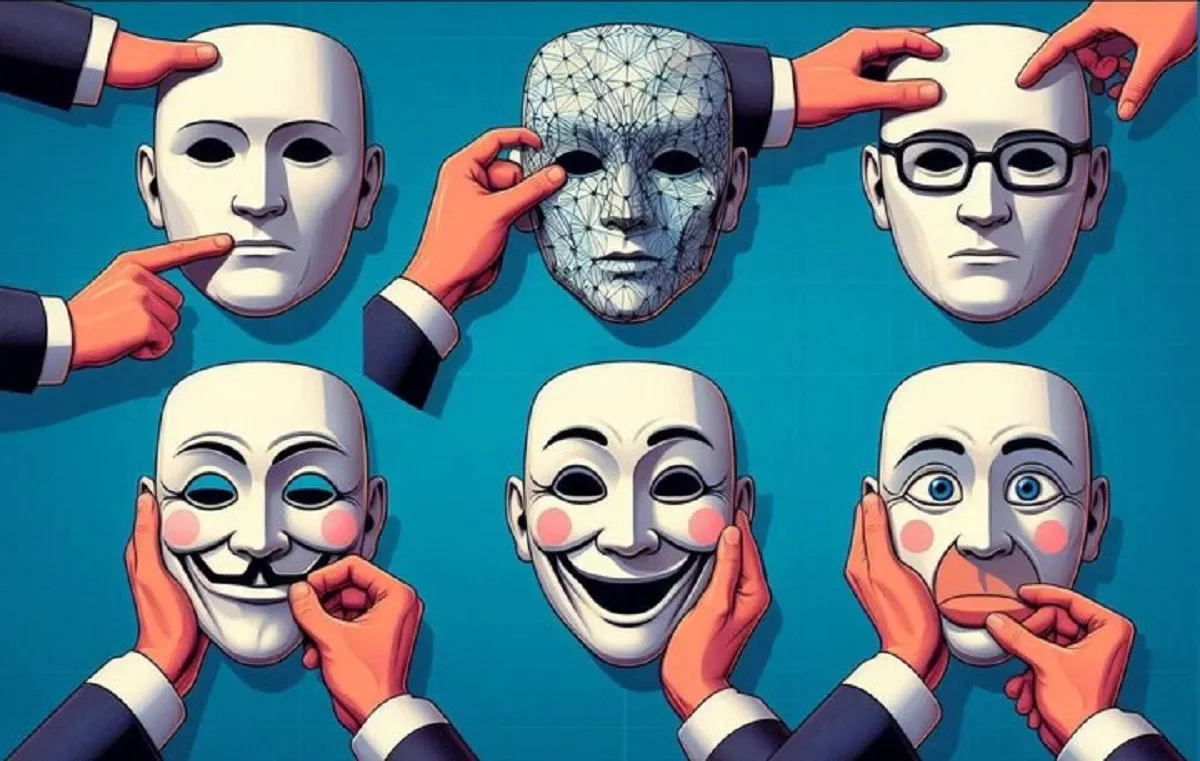
پژوهش جدید دانشمندان چینی حاکی از این است که تغییر زبان میتواند نتایج آزمون شخصیتشناسی یک چتبات را تغییر دهد.
از یک چتبات هوش مصنوعی بخواهید تا یک پرسشنامه شخصیتشناسی را به زبان انگلیسی تکمیل کند و سپس همان را به زبان ماندارین از آن بخواهید. خواهید دید که پاسخهای آن، تصویر متفاوتی را نشان میدهند.
به گزارش ایسنا به نقل از تکاکسپلور، تغییر زبان در آزمایشهای پنج سیستم، میزان شدت بیان ویژگیهایی مانند کنجکاوی، همکاری و قابلیت اطمینان در پاسخها را تغییر داد. این تغییرات همگی در یک جهت نبودند. برای نمونه، پاسخهای مدل «ChatGPT-4o» به زبان انگلیسی نشاندهنده گشودگی ذهنی بیشتری بود؛ در حالی که پاسخهای مدل «DeepSeek-V3» به زبان ماندارین در این شاخص امتیاز بالاتری را به دست آوردند. کشوری که مدل در آن توسعه یافته بود، سرنخهایی را درباره این الگو ارائه میداد، اما در عین حال ممکن بود به انتظارات گمراهکننده نیز منجر شود.
«یوزان هانگ»(Yuzhan Hang)، پژوهشگر «دانشگاه علم و فناوری چین»(USTC) و همکارانش برای مقایسه پاسخهای تولیدشده، از آزمونهای شخصیتشناسی انسانی استفاده کردند؛ بدون این که پاسخها را دلیلی بر آن بدانند که چتباتها دارای شخصیت یا احساسات انسانی هستند.
این گروه پژوهشی بین ژانویه و مارس ۲۰۲۵، مدلهای «ChatGPT-4o»، «Gemini 2.0 Flash»، «DeepSeek-V3»، «Ernie 3.5» و «Le Chat» را آزمایش کردند. هر یک از این مدلها پرسشنامههایی را به زبانهای انگلیسی و ماندارین تکمیل کردند و Le Chat به زبان فرانسوی نیز مورد ارزیابی قرار گرفت.
پرسشهای نظرسنجی آنها برگرفته از «پرسشنامه پنج عامل بزرگ -۲»(Big Five Inventory-2) بود. ۶۰ عبارت موجود در این پرسشنامه، از پاسخدهندگان میخواهد تا میزان موافقت خود را در مقیاس پنجدرجهای مشخص کنند. این کار به ترسیم نیمرخی از ویژگیهای کلی و خصوصیات جزئیتر کمک میکند. برای نمونه، گشودگی ذهن شامل کنجکاوی ذهنی، تخیل خلاق و حساسیت نسبت به هنر و زیبایی است.
پژوهشگران از نسخههای زبانی معتبر استفاده کردند و به مدلها گفتند که به جای جعل هویت افراد، خودشان پاسخ دهند. آنها هر ارزیابی را ۳۰ بار برای هر زبان تکرار کردند. در آزمایشهای مکرر، ویژگیهای کلی نسبتاً ثابت بودند. مدلها عموماً خود را مطلوب، دارای روحیه همکاری و قابل اعتماد، با تمایل نسبتاً کم به احساسات منفی توصیف میکردند.
تغییر زبان، این خودتوصیفی را تغییر داد. میانگین امتیاز گشودگی ذهنی برای مدل ChatGPT-4o در زبان انگلیسی ۴.۷۴ از ۵ و در زبان ماندارین ۴.۰۳ بود. این روند درباره مدل DeepSeek-V3 برعکس بود؛ به طوری که امتیاز آن در زبان انگلیسی ۴.۳۸ و در زبان ماندارین ۴.۸۱ ثبت شد. این امتیازها صرفاً نحوه پاسخ مدلها به پرسشنامهها را توصیف میکنند. آنها نشان نمیدهند که آیا یک مدل در بررسی ایدههای ناآشنا در گفتوگو، خلاقتر یا بهتر شده است.
به نظر میرسد برخی تفاوتها از پیشینه توسعه مدلها پیروی میکنند. مدلهای ChatGPT-4o و Le Chat در زبان انگلیسی نسبت به زبان ماندارین، امتیاز بالاتری را در توافقپذیری، وظیفهشناسی و روشنفکری به دست آوردند. مدلهای توسعهیافته در چین هنگام پاسخ دادن به زبان ماندارین، در چندین ویژگی از جمله اعتماد و کنجکاوی فکری، امتیاز بالاتری را گرفتند، اما بازی Gemini 2.0 Flash، این توضیح ساده پیرامون ملیت را بر هم زد. با وجود ریشههای آمریکایی این مدل، پاسخهای ماندارین آن در مقایسه با پاسخهای انگلیسیاش، امتیاز بالاتری را در وظیفهشناسی و امتیاز پایینتری را برای احساسات منفی به همراه داشت.
مکان توسعهدهنده آشکار نمیکند که چه فرهنگهایی در دادههای آموزشی یک مدل بازتاب یافتهاند. این پژوهش نتوانست چنین تأثیراتی را از عواملی همچون تفاوت در طراحی مدل، رویههای آموزشی یا نحوه تفسیر عبارتهای ترجمهشده تفکیک کند.
این پاسخهای عموماً تحسینبرانگیز، چندین توضیح احتمالی دارند. آموزشهایی که با هدف مفید و مشارکتی کردن چتباتها انجام میشوند، میتوانند در این نتایج نقش داشته باشند؛ همان طور که الگوهای توصیف مطلوب از خود که از نوشتار انسان آموخته شدهاند میتوانند در این نتایج نقش داشته باشند.
خودِ موقعیتِ آزمون نیز ممکن است اهمیت داشته باشد. مطالعهای پیشین که در نشریه «PNAS Nexus» منتشر شده، نشان میدهد که وقتی قالبِ پرسشنامه، ماهیتِ سنجشِ شخصیت را آشکارتر میکند، مدلها پاسخهایی ارائه میدهند که از نظر اجتماعی مطلوبتر هستند.
این پژوهش، ویژگیهای هوش مصنوعی را با دادههای حاصل از پرسشنامههای انسانی در آمریکا، چین و فرانسه مقایسه کرد. هیچ کدام از مدلها به طور کامل با گروه مرجع انسانی خود مطابقت نداشتند؛ بهویژه ویژگیهای مدل چینی که ترکیبی از دادهها بود، تفاوت بسیار چشمگیری را با نمونه انسانی چینی نشان داد. با وجود این، نمونههای مرجع انسانی نیز متفاوت بودند و به طور یکسان نماینده کشورهایشان نبودند. به عنوان مثال، نمونه پنج عامل بزرگ چینی فقط شامل دانشجویان دانشگاه بود.
برای پژوهشگرانی که چتباتها را به عنوان جایگزین شرکتکنندگان انسانی نظرسنجی در نظر میگیرند، یافتهها یک مشکل را آشکار میکنند؛ این که پاسخهای سازگار و قابل قبول هنوز هم میتوانند به طور سیستماتیک با افرادی که نمایش داده میشوند، متفاوت باشند. این پژوهش، مدلهایی را آزمایش کرد که به آنها آموزش داده شده بود تا به عنوان خودشان پاسخ دهند. بنابراین، این پژوهش مشخص نمیکند که شبیهسازیهای دقیق از گروههای ویژه چقدر خوب عمل میکنند.
پژوهشگران نوشتند: یافتههای ما نشان میدهند که مدلهای زبانی بزرگ از نظر روانشناختی پایدار اما از نظر فرهنگی ناسازگار هستند و این ویژگیها توسط محتوای آموزشی و زبان تعامل شکل میگیرد. پروتکلهای همترازی، همگرایی به سمت گرایشهای اجتماعی را ترویج میدهند، اما واگرایی فرهنگی یا تعدیل زبانی در بیان شخصیت را از بین نمیبرند.
بررسی گفتوگوهای عادی میتواند نشان دهد که آیا تفاوتهای مشاهدهشده در پرسشنامهها، در تعاملات واقعی نیز نمود پیدا میکنند یا خیر. تعیین زبان یک چتبات در حال حاضر بخشی از تعیین شرایط آزمایش به شمار میرود و هر پاسخ روان ارائهشده توسط آن همچنان باید با پاسخ انسانی جایگزین یا نماینده آن مقایسه و سنجیده شود.
این پژوهش در مجله «Royal Society Open Science» به چاپ رسید.



لینک کوتاه: کپی لینک
ما و نوای موسیقی خیابانی 3000 کلمه اصلی زبان انگلیسی کدامند؟ آموزش آسان همه این واژه ها در عصر ایران دیدنی های امروز؛ از اعتراضات سراسری در اروپا تا دوچرخه های اشتراکی در چین ادعای روبیو: اگر ایرانیها سلاح هستهای داشتند، میتوانستند بگویند «تنگه هرمز متعلق به ماست! درخشش فیلم «من راکی را بازی میکنم» در جشنواره لندن شوک ترامپ به انتخابات اسرائیل با حمایت علنی از نتانیاهو الیف شافاک ؛ آیا در دوران آشوب، نوشتن داستان ارزشی دارد؟ مخبر: با جانشینی آیت الله مجتبی خامنه ای، کشور در آرامش است/ مادر بمب ها در خود آمریکا منفجر شده است قتلعام خانوادگی در برج معروف شمال تهران برادران کوئن شایعه اختلاف را رد کردند ؛ بازگشت به سینمای مشترک پس از ۸ سال معمای سفر لاوروف؛ میانجی گری یا تثبیت شراکت با ایران؟ شخصیت چتباتها با تغییر زبان آنها عوض میشود! سرنوشت نامعلوم اصلاح تعرفههای پرستاری و گلایههای مستمر کادر درمان صفای لری؛ گندم دویست من، یک تومان! یک عامل افزایش خطر عفونت با بالا رفتن سن
نظرسنجی
پیش بینی شما از نتیجه انتخابات میان دوره ای کنگره آمریکا؟